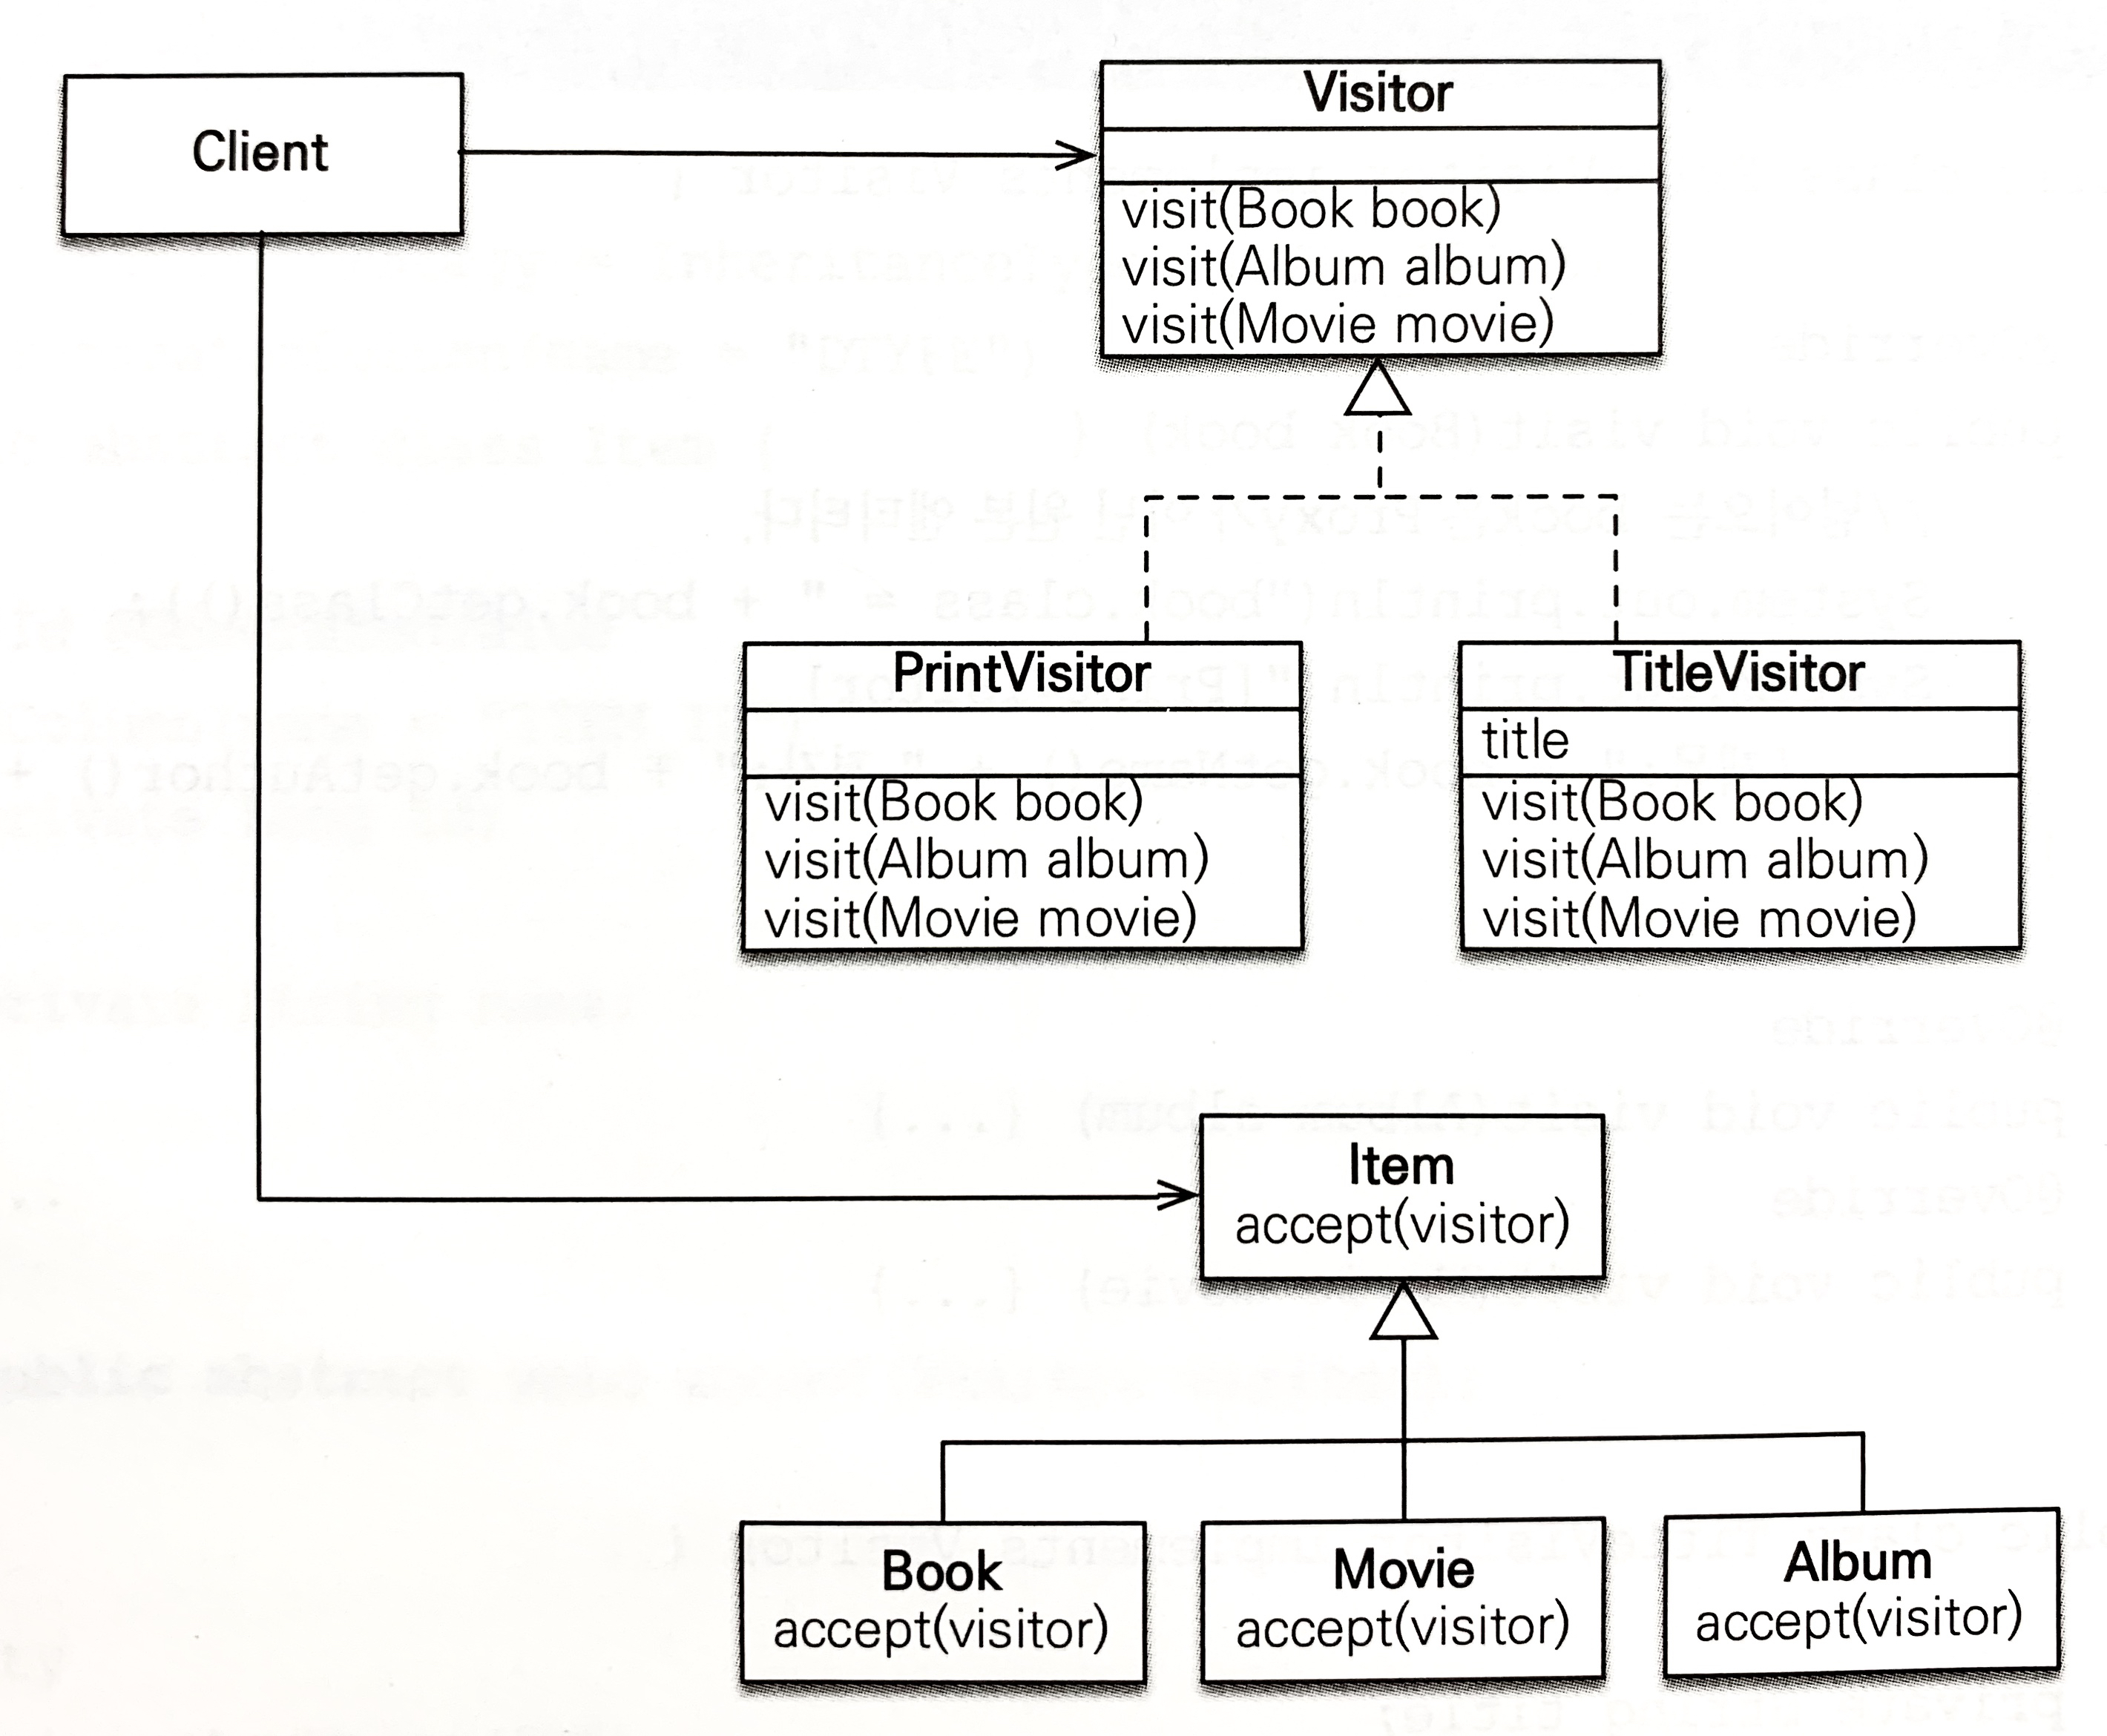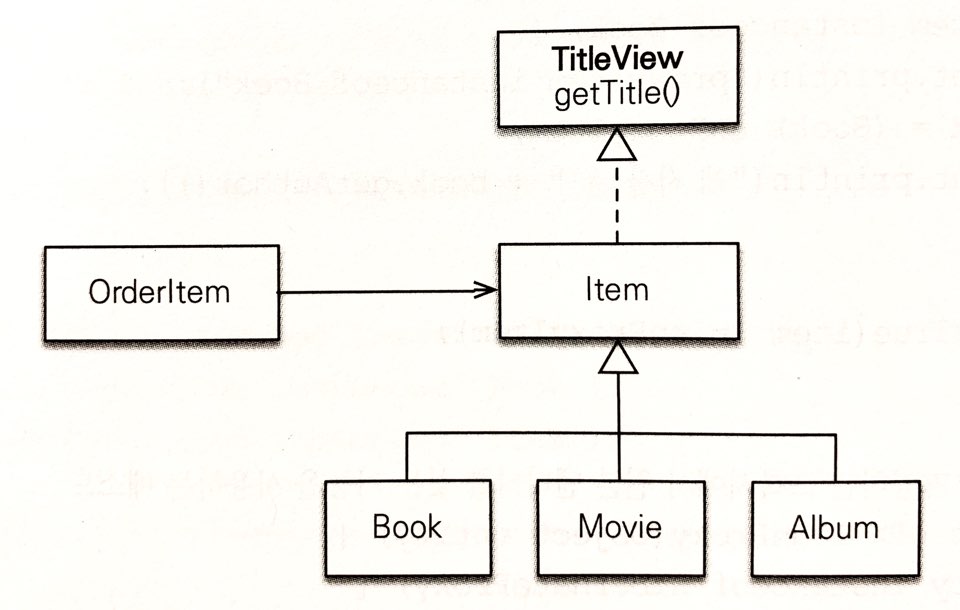
{"componentChunkName":"component---src-templates-post-jsx","path":"/[JPA]15/","result":{"data":{"site":{"siteMetadata":{"title":"SUbbb"}},"markdownRemark":{"id":"838bd515-9bd3-5d4b-8f49-723d3f55688c","excerpt":"자바 ORM 표준 JPA 프로그래밍 - 김영한을 읽고 인용하고 정리하는 POST입니다. 💫 예외 처리 ➰ JPA 표준 예외 정리 JPA 표준 예외들은  의 자식 클래스다. 그리고 이 예외 클래스는  의 자식이다. 따라서 JPA 예외는 모두 언체크 예외다. (명시적으로 예외 처리를 강제하지 않는 예외) JPA 표준 예외는 크게 2가지로 나눌 수 있다. 트랜…","html":"<p><em>[자바 ORM 표준 JPA 프로그래밍 - 김영한]을 읽고 인용하고 정리하는 POST입니다.</em></p>\n<h2>💫 예외 처리</h2>\n<h3>➰ JPA 표준 예외 정리</h3>\n<p>JPA 표준 예외들은 <code class=\"language-text\">javax.persistence.PersistenceException</code> 의 자식 클래스다. 그리고 이 예외 클래스는 <code class=\"language-text\">RuntimeException</code> 의 자식이다.</p>\n<ul>\n<li>따라서 JPA 예외는 모두 <strong>언체크 예외</strong>다. (명시적으로 예외 처리를 강제하지 않는 예외)</li>\n</ul>\n<p>JPA 표준 예외는 크게 2가지로 나눌 수 있다.</p>\n<ul>\n<li>\n<p><strong>트랜잭션 롤백을 표시하는 예외</strong></p>\n<ul>\n<li>심각한 예외로, 복구해선 안된다.</li>\n<li>트랜잭션을 강제로 커밋해도 수행되지 않고, <code class=\"language-text\">RollbackException</code> 예외가 발생한다.</li>\n</ul>\n</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">트랜잭션 롤백을 표시하는 예외</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.EntityExistsException</code></td>\n</tr>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.EntityNotFoundException</code></td>\n</tr>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.OptimisticLockException</code></td>\n</tr>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.PessimisticLockException</code></td>\n</tr>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.RollbackException</code></td>\n</tr>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.TransactionRequiredException</code></td>\n</tr>\n</tbody>\n</table>\n<ul>\n<li>\n<p><strong>트랜잭션 롤백을 표시하지 않는 예외</strong></p>\n<ul>\n<li>심각하지 않은 예외로, 개발자에게 트랜잭션 커밋 여부가 달려있다.</li>\n</ul>\n</li>\n</ul>\n<table>\n<thead>\n<tr>\n<th align=\"center\">트랜잭션 롤백을 표시하지 않는 예외</th>\n</tr>\n</thead>\n<tbody>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.NoResultException</code></td>\n</tr>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.NonUniqueResultException</code></td>\n</tr>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.LockTimeoutException</code></td>\n</tr>\n<tr>\n<td align=\"center\"><code class=\"language-text\">javax.persistence.QueryTimeoutException</code></td>\n</tr>\n</tbody>\n</table>\n<h3>➰ 스프링 프레임워크의 JPA 예외 변환</h3>\n<p>\"서비스 계층에서 데이터 접근 계층의 구현 기술에 직접 의존하는 것은 좋은 설계라 할 수 없다.\"</p>\n<ul>\n<li>예외 또한 마찬가지이다. </li>\n<li>스프링 프레임워크는 데이터 접근 계층에 대한 예외를 추상화해서 개발자에게 제공한다.</li>\n</ul>\n<p>|JPA 예외|스프링 변환 예외|\n|<code class=\"language-text\">javax.persistence.PersistenceException</code>|<code class=\"language-text\">org.springframework.orm.jpa.JpaSystemException</code>|\n|<code class=\"language-text\">javax.persistence.NoResultException</code>|<code class=\"language-text\">org.springframework.dao.EmptyResultDataAccessException</code>|\n|<code class=\"language-text\">javax.persistence.NonUniqueResultException</code>|<code class=\"language-text\">org.springframework.dao.IncorrectResultSizeDataAccessException</code>|\n|<code class=\"language-text\">javax.persistence.LockTimeoutException</code>|<code class=\"language-text\">org.springframework.dao.CannotAcquireLockException</code>|\n|<code class=\"language-text\">javax.persistence.QueryTimeoutException</code>|<code class=\"language-text\">org.springframework.dao.QueryTimeoutException</code>|\n|<code class=\"language-text\">javax.persistence.EntityExistsException</code>|<code class=\"language-text\">org.springframework.dao.DataIntegrityViolationException</code>|\n|<code class=\"language-text\">javax.persistence.EntityNotFoundException</code>|<code class=\"language-text\">org.springframework.orm.jpa.JpaObjectRetrievalFailureException</code>|\n|<code class=\"language-text\">javax.persistence.OptimisticLockException</code>|<code class=\"language-text\">org.springframework.orm.jpa.JpaOptimisticLockingFailureException</code>|\n|<code class=\"language-text\">javax.persistence.PessimisticLockException</code>|<code class=\"language-text\">org.springframework.dao.PessimisticLockingFailureException</code>|\n|<code class=\"language-text\">javax.persistence.TransactionRequiredException</code>|<code class=\"language-text\">org.springframework.dao.InvalidDataAccessApiUsageException</code>|\n|<code class=\"language-text\">javax.persistence.RollbackException</code>|<code class=\"language-text\">org.springframework.transaction.TranscationSystemException</code>|</p>\n<h3>➰ 스프링 프레임워크에 JPA 예외 변환기 적용</h3>\n<p>추상화된 예외로의 변경을 위해서는 <code class=\"language-text\">PersistenceExceptionTranslationPostProcessor</code> 를 스프링 빈으로 등록해야 한다.</p>\n<ul>\n<li><code class=\"language-text\">@Repository</code> annotation이 사용된 곳에 예외 변환 AOP를 적용해서 JPA 예외를 스프링 프레임워크가 추상화한 예외로 변환해준다.</li>\n</ul>\n<p><code class=\"language-text\">getSingleResult()</code> 메소드를 사용하는 <code class=\"language-text\">@Repository</code> 클래스가 있다고 가정하자.</p>\n<ul>\n<li>이 메소드는 조회된 결과가 없으면 <code class=\"language-text\">javax.persistence.NoResultException</code> 이 발생한다.</li>\n<li>\n<p>이 예외가 <code class=\"language-text\">getSingleResult()</code> 를 사용하는 메소드를 빠져 나갈 때, <strong>등록한 AOP 인터셉터가 동작해 해당 예외를 변환해서 반환</strong>한다.</p>\n<ul>\n<li>따라서, 요청자는 스프링 프레임워크가 추상화한 예외를 받게 된다.</li>\n</ul>\n</li>\n<li>만약 변환하고 싶지 않다면, <code class=\"language-text\">throws</code> 절에 그대로 반환할 JPA 예외나, JPA 예외의 부모 클래스를 직접 명시한다.</li>\n</ul>\n<h3>➰ 트랜잭션 롤백 시 주의사항</h3>\n<p>트랜잭션을 롤백하는 것은 데이터베이스의 반영사항만 롤백하는 것이지 수정한 자바 객체까지 원상태로 복구해주지는 않는다.</p>\n<ul>\n<li>즉, 객체는 수정된 채로 영속성 컨텍스트에 남아 있다. 트랜잭션이 롤백된 영속성 컨텍스트를 그대로 사용하는 것은 위험하다!</li>\n</ul>\n<blockquote>\n<p>새로운 영속성 컨텍스트를 생성해서 사용하거나, <code class=\"language-text\">em.clear()</code> 를 호출해 영속성 컨텍스트를 초기화한 후 사용해야 한다!</p>\n</blockquote>\n<p>스프링 프레임워크의 영속성 컨텍스트 기존 전략인 트랜잭션당 영속성 컨텍스트 전략은 문제가 발생하면 트랜잭션 AOP 종료 시점에 트랜잭션을 롤백하면서 영속성 컨텍스트로 함께 종료하여 문제가 발생하지 않는다.</p>\n<p>문제는 OSIV처럼 영속성 컨텍스트의 범위가 더 넓어 <strong>여러 트랜잭션이 하나의 영속성 컨텍스트를 사용할 때 발생</strong>한다.</p>\n<ul>\n<li>트랜잭션을 롤백해서 영속성 컨텍스트에 이상이 발생해도 다른 트랜잭션에서 해당 영속성 컨텍스트를 그대로 사용하기 때문이다.</li>\n<li>스프링 프레임워크는 영속성 컨텍스트의 범위를 트랜잭션의 범위보다 넓게 설정하면 트랜잭션 롤백 시 영속성 컨텍스트를 초기화(<code class=\"language-text\">em.clear()</code>)해서 잘못된 영속성 컨텍스트를 사용하지 않도록 방지한다.</li>\n</ul>\n<hr>\n<h2>💫 엔티티 비교</h2>\n<p>영속성 컨텍스트 내부에는 엔티티 인스턴스를 보관하기 위한 1차 캐시가 있다. 이는 영속성 컨텍스트와 생명주기를 같이 한다.</p>\n<ul>\n<li>이 1차 캐시를 이용해 변경 감지 기능도 동작하고, 데이터베이스를 통하지 않고 데이터를 바로 조회할 수도 있다.</li>\n<li>\n<p>가장 큰 장점으로는 <strong>애플리케이션 수준의 반복 가능한 읽기</strong>가 있다.</p>\n<ul>\n<li>같은 영속성 컨텍스트에서 엔티티를 조회하면 항상 같은 엔티티 인스턴스를 반환한다.</li>\n<li>이는 단순한 동등성 비교 수준이 아닌 정말 <strong>주소값이 같은 인스턴스를 반환</strong>한다.</li>\n</ul>\n</li>\n</ul>\n<h3>➰ 영속성 컨텍스트가 같을 때 엔티티 비교</h3>\n<p>회원가입 테스트 케이스를 예로 사용해보자. </p>\n<ul>\n<li>\n<p>먼저, 해당 테스트는 <code class=\"language-text\">@Transcational</code> annotation을 사용해 트랜잭션 안에서 테스트를 시작하여 테스트의 범위와 트랜잭션의 범위가 같다. 따라서, 테스트 전체에서 동일한 영속성 컨텍스트에 접근한다.</p>\n<ul>\n<li>회원을 생성하고, 영속성 컨텍스트에 저장한다.</li>\n<li>그리고 저장된 회원을 찾아서 저장한 회원과 비교한다.</li>\n<li><strong>이 둘은 완전히 같은 인스턴스</strong>이다. </li>\n</ul>\n</li>\n</ul>\n<blockquote>\n<p>같은 트랜잭션 범위에 있어 같은 영속성 컨텍스트를 사용하기 때문이다.</p>\n</blockquote>\n<p>영속성 컨텍스트가 같으면, 엔티티를 비교할 때 다음 3가지 조건을 모두 만족한다.</p>\n<ul>\n<li>동일성(<code class=\"language-text\">identical</code>) : == 비교가 같다.</li>\n<li>동등성(<code class=\"language-text\">equinalent</code>) : <code class=\"language-text\">equals()</code> 비교가 같다.</li>\n<li>데이터베이스 동등성 : <code class=\"language-text\">@Id</code> 인 데이터베이스 식별자가 같다.</li>\n</ul>\n<blockquote>\n<p>테스트에도 <code class=\"language-text\">@Transcational</code> 이 있고, 서비스에도 <code class=\"language-text\">@Transcational</code> 가 있다. 기본 전략은 먼저 시작된 트랜잭션이 있으면 그대로 이어 받아 사용하고, 없으면 새로 시작하는 것이다. <br/>\n다른 전략을 사용하려면 <code class=\"language-text\">@Transcational(propagation = Propagation.***)</code> 으로 변경하면 된다.</p>\n</blockquote>\n<blockquote>\n<p>테스트 클래스에 <code class=\"language-text\">@Transcational</code> 를 적용하면 테스트가 끝날 때 트랜잭션 커밋없이 강제로 롤백한다. 데이터베이스에 영향 없이 테스트를 반복적으로 수행하기 위함이다. </p>\n<ul>\n<li>문제는 롤백 시 영속성 컨텍스트를 플러시하지 않아 플러시 시점에 어떤 SQL이 실행되는지 로그를 확인할 수 없다는 것이다. 이를 위해서는 테스트 마지막에 <code class=\"language-text\">em.flush()</code> 로 영속성 컨텍스트를 강제로 플러시하면 된다.</li>\n</ul>\n</blockquote>\n<h3>➰ 영속성 컨텍스트가 다를 때 엔티티 비교</h3>\n<p>테스트 클래스에 <code class=\"language-text\">@Transactional</code> 이 없고, 서비스에만 있다면 서비스와 레포지토리에서만 트랜잭션과 영속성 컨텍스트가 살아있다.</p>\n<ul>\n<li>즉, 테스트에서는 준영속 상태이다!</li>\n<li>테스트는 실패하게 된다!</li>\n<li>테스트 코드에서 서비스 계층의 메소드를 호출해 회원가입 기능을 시도하면, 서비스 계층에서 트랜잭션이 시작되고, \"영속성 컨텍스트 1\"이 생성된다.</li>\n<li>레포지토리에서 <code class=\"language-text\">em.persist()</code> 를 호출해서 <code class=\"language-text\">member</code> 엔티티를 영속화한다.</li>\n<li>서비스 계층이 끝날 때 트랜잭션이 커밋되면서 영속성 컨텍스트가 플러시된다. 이때 트랜잭션과 영속성 컨텍스트 1이 종료된다. 따라서 <code class=\"language-text\">member</code> 엔티티 인스턴스는 준영속 상태가 된다.</li>\n<li>테스트 코드에서 레포지토리의 메소드를 호출해 저장한 엔티티를 조회하면 레포지토리 계층에서 새로운 트랜잭션이 시작되면서 새로운 \"영속성 컨텍스트 2\"가 생성된다.</li>\n<li>저장된 회원을 조회하지만, 새로 생성된 영속성 컨텍스트 2에는 찾는 회원이 존재하지 않는다. 따라서 데이터베이스에서 회원을 찾아온다.</li>\n<li>데이터베이스에서 조회된 회원 엔티티를 영속성 컨텍스트에 보관하고 반환한다.</li>\n<li>호출한 메소드가 종료되면서 트랜잭션이 종료되고 영속성 컨텍스트 2가 종료된다.</li>\n</ul>\n<p>각각 다른 영속성 컨텍스트에서 관리되었기 때문에 등록하고, 조회한 엔티티들은 서로 다른 인스턴스이다!</p>\n<ul>\n<li>즉 <code class=\"language-text\">assertTrue(member == findMember)</code> 는 실패한다.</li>\n<li>인스턴스는 다르지만 사실 같은 데이터베이스 로우를 가르키고 있어 같은 엔티티로 보아야 한다.</li>\n</ul>\n<p>동일성 비교가 아닌 동등성 비교를 수행해보자.</p>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">member.getId().equals(findMember.getId())</code>\n        </deckgo-highlight-code>\n<p>하지만 동등성 비교는 엔티티를 영속화해야 식별자를 얻을 수 있다는 문제가 있다. </p>\n<ul>\n<li>엔티티를 영속화하기 전에는 식별자 값이 <code class=\"language-text\">null</code> 이므로 정확한 비교를 할 수 없다. </li>\n<li>물론 식별자 값을 직접 부여하는 방식을 사용할 때는 데이터베이스 식별자 비교도 가능하다. 하지만 항상 식별자를 먼저 부여하는 것을 보장하기는 쉽지 않다.</li>\n</ul>\n<p><strong>\"엔티티를 비교할 때는 비즈니스 키를 활용한 동등성 비교를 권장한다.\"</strong></p>\n<ul>\n<li><code class=\"language-text\">equals()</code> 메소드를 오버라이딩하여 비즈니스 키가 되는 필드들을 선택한다. </li>\n</ul>\n<hr>\n<h2>💫 프록시 심화 주제</h2>\n<p>프록시는 원본 엔티티를 상속받아 만들어지므로 엔티티를 사용하는 클라이언트 입장에는 이를 구분하지 않고 사용할 수 있다.</p>\n<h3>➰ 영속성 컨텍스트와 프록시</h3>\n<p>영속성 컨텍스트는 자신이 관리하는 영속 엔티티의 동일성을 보장한다. </p>\n<ul>\n<li>프록시 엔티티와 원본 엔티티를 조회하면 둘은 서로 다른 인스턴스로 생각할 수 있지만, 이렇게 되면 영속성 컨텍스트가 영속 엔티티의 동일성을 보장하지 못하는 문제가 발생한다.</li>\n</ul>\n<p>따라서 영속성 컨텍스트는 프록시로 조회된 엔티티에 대해서 같은 엔티티를 찾는 요청이 오면, 원본 엔티티가 아닌 처음 조회된 프록시를 반환한다. 이를 통해 영속 엔티티의 동일성을 보장한다.</p>\n<ul>\n<li>반대로 원본 엔티티를 먼저 조회하면, 프록시를 반환할 이유 없이 원본을 반환한다.</li>\n</ul>\n<h3>➰ 프록시 타입 비교</h3>\n<p>프록시로 조회한 엔티티의 타입을 비교할 때는 <code class=\"language-text\">==</code> 비교가 아닌 <code class=\"language-text\">instanceof</code> 를 사용해야 한다.</p>\n<ul>\n<li>프록시는 원본 엔티티의 자식 타입이므로 <code class=\"language-text\">instanceof</code> 연산을 사용하면 된다.</li>\n</ul>\n<h3>➰ 프록시 동등성 비교</h3>\n<p>엔티티의 동등성을 비교하려면 비즈니스 키를 사용해 <code class=\"language-text\">equals()</code> 메소드를 오버라이딩하고 비교하면 된다.</p>\n<ul>\n<li>하지만 IDE나 외부 라이브러리를 사용해서 구현한 <code class=\"language-text\">equals()</code> 메소드로 엔티티를 비교할 때, 비교 대상이 원본 엔티티면 문제가 없지만, 프록시면 문제가 발생할 수 있다.</li>\n</ul>\n<p>프록시와 <code class=\"language-text\">equals()</code> 비교를 할 때는 몇 가지 주의점이 있다.</p>\n<ul>\n<li>\n<p>프록시의 멤버변수에 직접 접근하는 경우, <code class=\"language-text\">equals()</code> 메소드를 구현할 때는 일반적으로 멤버변수를 직접 비교하는데, 프록시의 경우는 문제가 된다.</p>\n<ul>\n<li>왜냐면 프록시는 실제 데이터를 가지고 있지 않기 때문에 아무 값도 조회할 수 없는 것이다.</li>\n</ul>\n</li>\n<li>멤버변수를 <code class=\"language-text\">private</code> 으로 선언해 일반적인 상황에서는 프록시의 멤버변수에 직접 접근하는 문제가 발생하진 않지만, <code class=\"language-text\">equals()</code> 메소드는 자신을 비교하기 때문에 <code class=\"language-text\">private</code> 멤버변수에도 접근할 수 있다.</li>\n</ul>\n<p>\"프록시의 데이터를 조회할 때는 접근자(Getter)를 사용해야 한다.\"</p>\n<blockquote>\n<ul>\n<li>프록시 타입 비교는 <code class=\"language-text\">==</code> 비교 대신, <code class=\"language-text\">instanceof</code> 를 사용해야 한다.</li>\n<li>프록시의 멤버변수에 직접 접근하면 안되고, 접근자 메소드를 사용해야 한다.</li>\n</ul>\n</blockquote>\n<h3>➰ 상속관계와 프록시</h3>\n<p>상속관계를 프록시로 조회할 때 발생할 수 있는 문제점으로, <strong>프록시를 부모 타입으로 조회하면 문제가 발생</strong>한다.</p>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">@Test\npublic void 부모타입으로_프록시조회() {\n\t//테스트 데이터 준비\n\tBook saveBook = new Book();\n\tsaveBook.setName(&quot;jpaBook&quot;);\n\tsaveBook.setAuthor(&quot;kim&quot;);\n\tem.persist(saveBook);\n\n\tem.flush();\n\tem.clear();\n\n\t//테스트 시작\n\tItem proxyItem = em.getReference(Item.class, saveBook.getId());\n\tSystem.out.println(&quot;proxyItem = &quot; + proxyItem.getClass());\n\n\tif (proxyItem instanceof Book) {\n\t\tSystem.out.println(&quot;proxyItem instanceof Book&quot;);\n\t\tBook book = (Book) proxyItem;\n\t\tSystem.out.println(&quot;책 저자 = &quot; + book.getAuthor());\n\t}\n\n  //결과 검증\n  Assert.assertFalse(proxyItem.getClass() == Book.class);\n  Assert.assertFalse(proxyItem instanceof Book);\n  Assert.assertTrue(proxyItem instanceof Item);\n}</code>\n        </deckgo-highlight-code>\n<ul>\n<li>엔티티를 프록시로 조회하면, 실제 조회된 엔티티는 해당 부모 엔티티이므로, 부모 엔티티 타입 기반 원본 엔티티 인스턴스가 생성된다.</li>\n<li>프록시는 자식 엔티티(조회하려는 엔티티)를 기반으로 만들어진다.</li>\n</ul>\n<p>따라서 프록시와 부모 타입은 관계가 없어 결과 검증이 실패한다.</p>\n<p>또한 <strong><code class=\"language-text\">instanceof</code> 연산을 사용할 수 없고</strong>, <strong>하위 타입으로 다운캐스팅을 할 수 없다</strong>는 문제가 있다.</p>\n<p><strong>📌 JPQL로 대상 직접 조회</strong><br/>\n가장 간단한 방법은 처음부터 자식 타입을 직접 조회해서 필요한 연산을 하는 것이다.</p>\n<ul>\n<li>이 방법을 사용하면 다형성을 활용할 수 없다.</li>\n</ul>\n<p><strong>📌 프록시 벗기기</strong><br/>\nHibernate가 제공하는 기능을 사용해 프록시에서 원본 엔티티를 가져온다.</p>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">  ...\n\n  Item item = orderItem.getItem();\n  Item unProxyItem = unProxy(item);\n\n  if (unProxyItem instanceof Book) {\n    System.out.println(&quot;proxyItem instanceof Book&quot;);\n    Book book = (Book) unProxyItem;\n    System.out.println(&quot;책 저자 = &quot; + book.getAuthor());\n  }\n\n  Assert.assertTrue(item != unProxyItem);\n}\n\n// Hibernate가 제공하는 프록시에서 원본 엔티티를 찾는 기능을 사용하는 메소드\npublic static &lt;T&gt; T unProxy(Object entity) {\n  if (entity instanceof HibernateProxy) {\n    entity = ((HibernateProxy) entity)\n              .getHibernateLazyInitializer()\n              .getImplementation();\n  }\n\n  return (T) entity;\n}</code>\n        </deckgo-highlight-code>\n<ul>\n<li>영속성 컨텍스트는 한 번 프록시로 노출한 엔티티는 계속 프록시로 노출한다. (영속 엔티티의 동일성 보장, 클라이언트는 프록시인지 아닌지 구분하지 않고 사용 가능)</li>\n<li>이 방법은 프록시에서 원본 엔티티를 직접 꺼내 <strong>프록시와 원본 엔티티의 동일성 비교가 실패</strong>한다는 문제점이 있다.</li>\n</ul>\n<p><strong>📌 기능을 위한 별도의 인터페이스 제공</strong><br/>\n<img src='https://leejaedoo.github.io/assets/img/proxy3.jpeg' width='40%'></p>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">public interface TitleView {\n  String getTitle();\n}</code>\n        </deckgo-highlight-code>\n<ul>\n<li>특정 기능을 제공하는 인터페이스를 정의한다.</li>\n<li>\n<p>자식 클래스들은 인터페이스의 <code class=\"language-text\">getTitle()</code> 메소드를 각각 구현한다.</p>\n<ul>\n<li>구현체에 따라 각각 다른 <code class=\"language-text\">getTitle()</code> 메소드가 호출될 것이다.</li>\n</ul>\n</li>\n</ul>\n<p>이는 다형성을 활용하는 좋은 방법이다. 또한, 클라이언트가 대상 객체가 프록시인지 아닌지 구분하지 않아도 된다.</p>\n<p><strong>📌 비지터 패턴 사용</strong><br/>\n<img src='https://leejaedoo.github.io/assets/img/visitor.jpg' width='40%'></p>\n<ul>\n<li>\n<p>비지터 패턴은 <code class=\"language-text\">Visitor</code> 와 이를 받아들이는 대상 클래스로 구분된다.</p>\n<ul>\n<li>여기서 <code class=\"language-text\">Item</code> 은 비지터를 받아들이기만 하고, 실제 로직은 비지터가 처리한다.</li>\n</ul>\n</li>\n<li><code class=\"language-text\">Visitor</code> 에는 <code class=\"language-text\">visit()</code> 라는 메소드를 정의하고, 모든 대상 클래스를 받아들이도록 작성한다.</li>\n<li>\n<p>대상 클래스는 <code class=\"language-text\">accept(visitor)</code> 메소드를 추가해 비지터를 받아들일 수 있도록 한다. </p>\n<ul>\n<li>단순히 파라미터로 넘어온 <code class=\"language-text\">Visitor</code> 의 <code class=\"language-text\">visit(this)</code> 메소드를 호출해 자신을 파라미터로 넘긴다. </li>\n<li>따라서 <strong>실제 로직 처리를 비지터에 위임</strong>한다.</li>\n</ul>\n</li>\n</ul>\n<p>비지터 패턴을 사용하면 </p>\n<ul>\n<li>프록시에 대한 걱정 없이 안전하게 원본 엔티티에 접근할 수 있고,</li>\n<li><code class=\"language-text\">instanceof</code> 나 타입 캐스팅 없이 코드를 구현할 수 있다.</li>\n<li>알고리즘과 객체 구조를 분리해 구조를 수정하지 않고 새로운 동작을 추가할 수 있다.</li>\n</ul>\n<p>하지만 단점으로는</p>\n<ul>\n<li>너무 복잡하고 더블 디스패치를 사용하기에 이해가 어렵다.</li>\n<li>객체 구조가 변경되면 모든 <code class=\"language-text\">Visitor</code> 를 수정해야 한다.</li>\n</ul>\n<blockquote>\n<p><strong>더블 디스패치</strong>는 다중 디스패치의 특수한 형태로, 호출에 관련된 두 객체의 런타임 유형에 따라 다른 구체적인 함수에 함수 호출을 보내는 메커니즘이다.</p>\n</blockquote>\n<hr>\n<h2>💫 성능 최적화</h2>\n<h3>➰ N + 1 문제</h3>\n<p>JPA 개발 시 성능상 가장 주의해야 하는 문제이다.</p>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">@Entity\npublic class Member {\n\n  @Id @GeneratedValue\n  private Long id;\n\n  @OneToMany(mappedBy = &quot;member&quot;, fetch = FetchType.EAGER)\n  private List&lt;Order&gt; orders = new ArrayList&lt;&gt;();\n  ...\n\n}</code>\n        </deckgo-highlight-code>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">@Entity\n@Table(name = &quot;ORDERS&quot;)\npublic class Order {\n\n  @Id @GeneratedValue\n  private Long id;\n\n  @ManyToOne\n  private Member member;\n  ...\n\n}</code>\n        </deckgo-highlight-code>\n<ul>\n<li>회원과 주문 정보는 1:N, N:1 양방향 연관관계다. 그리고 회원이 참조하는 주문정보를 즉시 로딩으로 설정했다.</li>\n</ul>\n<p><strong>📌 즉시 로딩과 N + 1</strong><br/>\n특정 회원 하나를 조회하면 즉시 로딩으로 설정한 주문 정보도 함께 조회한다.</p>\n<ul>\n<li>SQL을 두 번 실행하는 것이 아닌 <strong>조인을 사용해 한 번의 SQL</strong>로 함께 조회한다.</li>\n<li>\n<p>하지만 JPQL을 사용하게 되면, JPA는 이를 분석해 SQL을 생성한다. 이때는 즉시 로딩과 지연 로딩에 대해 고려하지 않고 오직 JPQL만 사용해 SQL을 생성한다. </p>\n<ul>\n<li>SQL의 결과로 먼저 회원 엔티티를 애플리케이션에 로딩한다.</li>\n<li>이와 연관된 주문 컬렉션이 즉시 로딩이므로 JPA는 즉시 로딩을 위해 <code class=\"language-text\">ORDERS</code> 에 대한 SQL을 추가로 실행한다.</li>\n<li>총 2번의 SQL을 실행하는데, 만약 조회된 회원이 여러 명인 경우 각 회원에 대해 2번씩 실행하게 된다. 이러한 문제를 <strong>N + 1 문제</strong>라 한다.</li>\n</ul>\n</li>\n</ul>\n<p><strong>📌 지연 로딩과 N + 1</strong><br/>\n지연 로딩으로 설정하게 되면, JPQL에서는 N + 1 문제가 발생하지 않는다.</p>\n<ul>\n<li>\n<p>문제는 모든 회원에 대해 연관된 엔티티를 사용할 때 발생한다.</p>\n<ul>\n<li>연관된 엔티티를 초기화하는 수만큼 SQL이 실행될 수 있다. 결국 N + 1 문제가 발생하게 되고, 즉시 로딩과 지연 로딩 모두 발생할 수 있다.</li>\n</ul>\n</li>\n</ul>\n<p><strong>📌 페치 조인 사용</strong><br/>\nN + 1 문제를 해결하는 가장 일반적인 방법이다. </p>\n<ul>\n<li>SQL 조인을 사용해 연관된 엔티티를 함께 조회해 문제가 발생하지 않는다.</li>\n</ul>\n<p><strong>📌 Hibernate @BatchSize</strong><br/>\n<code class=\"language-text\">@BatchSize</code> annotation을 사용해 연관된 엔티티를 조회할 때 지정한 <code class=\"language-text\">size</code> 만큼 SQL의 IN 절을 사용해서 조회한다.</p>\n<ul>\n<li>만약 조회한 회원이 10명인데, <code class=\"language-text\">size=5</code> 로 지정하면 2번의 SQL만 추가로 실행한다.</li>\n<li>즉시 로딩의 경우, 조회 시점에 SQL이 2번 실행되고</li>\n<li>지연 로딩의 경우, 엔티티 최초 사용 시점에 1번의 SQL을 실행해 5건의 데이터를 로딩하고, 6번째 데이터 사용 시 1번의 SQL을 추가로 실행한다.</li>\n</ul>\n<p><strong>📌 Hibernate @Fetch(FetchMode.SUBSELECT)</strong><br/>\n<code class=\"language-text\">@Fetch</code> annotation에 <code class=\"language-text\">FetchMode</code> 를 <code class=\"language-text\">SUBSELECT</code> 로 사용하여 연관된 데이터를 조회할 때 서브 쿼리를 사용해 N + 1 문제를 해결할 수 있다.</p>\n<p><strong>📌 N + 1 정리</strong><br/>\n즉시 로딩이 아닌 지연 로딩을 사용하는 것을 추천한다. 성능 최적화가 필요한 곳에는 JPQL 페치 조인을 사용한다.</p>\n<p>JPA의 글로벌 페치 전략 기본값은 다음과 같다.</p>\n<ul>\n<li><code class=\"language-text\">@OneToOne</code> , <code class=\"language-text\">@ManyToOne</code> : 즉시 로딩</li>\n<li><code class=\"language-text\">@OneToMany</code> , <code class=\"language-text\">@ManyToMany</code> : 지연 로딩</li>\n</ul>\n<h3>➰ 읽기 전용 쿼리의 성능 최적화</h3>\n<p>엔티티가 영속성 컨텍스트에 관리되어 1차 캐시부터 변경 감지까지 여러 장점들이 있지만, 결국 더 많은 메모리를 사용한다는 단점이 있다.</p>\n<ul>\n<li>\n<p>전체 구매 내용을 출력하는 단순한 조회 화면이 있다고 가정한다.</p>\n<ul>\n<li>조회한 엔티티를 다시 조회할 일도 없고, 수정할 일도 없이 딱 1번만 읽어서 화면에 출력하면 된다.</li>\n<li>읽기 전용으로 엔티티를 조회해 메모리 사용량을 최적화할 수 있다.</li>\n</ul>\n</li>\n</ul>\n<p>다음 JPQL 쿼리를 최적화해보자.</p>\n<deckgo-highlight-code language=\"sql\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">select o from Order o</code>\n        </deckgo-highlight-code>\n<p><strong>📌 스칼라 타입으로 조회</strong><br/>\n엔티티가 아닌 스칼라 타입으로 모든 필드를 조회하는 것이다.</p>\n<ul>\n<li>스칼라 타입은 영속성 컨텍스트가 결과를 관리하지 않는다.</li>\n</ul>\n<deckgo-highlight-code language=\"sql\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">select o.id, o.name, o.price from Order p</code>\n        </deckgo-highlight-code>\n<p><strong>📌 읽기 전용 쿼리 힌트 사용</strong><br/>\nHibernate 전용 힌트인 <code class=\"language-text\">readOnly</code> 를 사용해 엔티티를 읽기 전용으로 조회한다.</p>\n<ul>\n<li>영속성 컨텍스트는 스냅샷을 보관하지 않아 메모리 사용량 최적화가 가능하다.</li>\n<li>단, 스냅샷이 없어지므로 변경 감지는 제공되지 않는다.</li>\n</ul>\n<deckgo-highlight-code language=\"java\" terminal=\"carbon\" theme=\"a11y-dark\" line-numbers=\"true\"  >\n          <code slot=\"code\">TypedQuery&lt;Order&gt; query = em.createQuery(&quot;select o from Order o&quot;, Order.class);\nquery.setHint(&quot;org.hibernate.readOnly&quot;, true);</code>\n        </deckgo-highlight-code>\n<p><strong>📌 읽기 전용 트랜잭션 사용</strong><br/>\n트랜잭션에 <code class=\"language-text\">readOnly = true</code> 옵션을 사용해 Hibernate 세션의 플러시 모드를 MANUAL로 설정한다.</p>\n<ul>\n<li>강제로 플러시를 호출하지 않는 한 플러시가 발생하지 않는다.</li>\n<li>즉, 트랜잭션 커밋해도 영속성 컨텍스트를 플러시하지 않는다.</li>\n</ul>\n<p><strong>📌 트랜잭션 밖에서 읽기</strong><br/>\n트랜잭션 없이 엔티티를 조회한다는 의미이다. 물론 JPA에서 데이터를 변경하려면 트랜잭션은 필수다. </p>\n<ul>\n<li>조회가 목적일 때만 사용해야 한다.</li>\n<li>트랜잭션이 없으므로 플러시가 일어나지 않아 조회 성능을 향상시킬 수 있다.</li>\n</ul>\n<blockquote>\n<p>기본적으로 플러시 모드는 AUTO로 설정되어 있다. 따라서 트랜잭션을 커밋하거나 쿼리를 실행하면 플러시가 작동한다. </p>\n<ul>\n<li>트랜잭션 자체가 없어지면 커밋할 일이 없다.</li>\n<li>또한 JPQL 쿼리도 트랜잭션 없이 실행하면 플러시를 호출하지 않는다.</li>\n</ul>\n</blockquote>\n<blockquote>\n<p><strong>읽기 전용 트랜잭션과 읽기 전용 쿼리 힌트를 동시에 사용하는 것이 가장 효과적이다!</strong></p>\n</blockquote>\n<h3>➰ 배치 처리</h3>\n<p>수 백만 건의 더ㅔ이터를 배치 처리해야 하는 상황에는 적절한 단위로 영속성 컨텍스트를 초기화해야 메모리 부족 오류가 발생하지 않을 것이다.</p>\n<p><strong>📌 JPA 등록 배치</strong><br/>\n반복문을 이용해 특정 개수의 엔티티 저장을 처리할 때마다 플러시를 호출하고, 영속성 컨텍스트를 초기화한다.</p>\n<p>수정 배치 처리는 2가지 방법을 주로 사용한다.</p>\n<ul>\n<li><strong>페이징 처리</strong>: 데이터베이스 페이징 기능을 사용한다.</li>\n<li><strong>커서</strong>: 데이터베이스가 지원하는 커서 기능을 사용한다.</li>\n</ul>\n<p><strong>📌 JPA 페이징 배치 처리</strong><br/>\n한 번에 특정 개수만큼의 데이터를 페이징 쿼리로 조회하면서 특정 필드의 값을 수정한다.</p>\n<ul>\n<li>페이지 단위마다 영속성 컨텍스트를 플러시하고 초기화한다.</li>\n</ul>\n<p>JPA는 JDBC 커서를 지원하지 않는다.</p>\n<ul>\n<li>따라서 <strong>Hibernate 세션</strong>을 사용해 커서를 사용해야 한다.</li>\n</ul>\n<blockquote>\n<p><strong>커서</strong>: 일련의 데이터에 순차적으로 액세스할 때 검색 및 \"현재 위치\"를 포함하는 데이터 요소</p>\n</blockquote>\n<p><strong>📌 Hibernate scroll 사용</strong><br/>\nHibernate는 <code class=\"language-text\">scroll</code> 이라는 이름으로 JDBC 커서를 지원한다.</p>\n<ul>\n<li>먼저 <code class=\"language-text\">em.unwrap()</code> 메소드로 Hibernate 세션을 구한다.</li>\n<li>\n<p>쿼리를 조회하면서 <code class=\"language-text\">scroll()</code> 메소드로 <code class=\"language-text\">ScrollableResults</code> 객체를 반환받는다.</p>\n<ul>\n<li>이 객체의 <code class=\"language-text\">next()</code> 메소드를 호출하면 엔티티를 하나씩 조회할 수 있다.</li>\n</ul>\n</li>\n</ul>\n<p><strong>📌 Hibernate 무상태 세션 사용</strong><br/>\n무상태 세션은 영속성 컨텍스트를 만들지 않고 심지어 2차 캐시도 사용하지 않는다.</p>\n<ul>\n<li>엔티티를 수정하려면 무상태 세션이 제공하는 <strong><code class=\"language-text\">update()</code> 메소드를 직접 호출</strong>해야 한다.</li>\n</ul>\n<h3>➰ SQL 쿼리 힌트 사용</h3>\n<p>JPA는 데이터베이스 SQL 힌트 기능을 제공하지 않는다. SQL 힌트를 사용하려면 Hibernate를 직접 사용해야 한다.</p>\n<ul>\n<li>SQL 힌트는 Hibernate 쿼리가 제공하는 <code class=\"language-text\">addQueryHint()</code> 메소드를 사용한다.</li>\n</ul>\n<h3>➰ 트랜잭션을 지원하는 쓰기 지연과 성능 최적화</h3>\n<p><strong>📌 트랜잭션을 지원하는 쓰기 지연과 JDBC 배치</strong><br/>\n네트워크 호출 한 번은 단순한 메소드를 수만 번 호출하는 것보다 더 많은 비용이 든다.</p>\n<ul>\n<li>\n<p>JDBC가 제공하는 SQL 배치 기능을 사용하면 SQL을 모아서 데이터베이스에 한 번에 보낼 수 있다.</p>\n<ul>\n<li>하지만 이는 코드의 많은 수정을 요구한다.</li>\n<li>그래서 보통 수백 수천 건 이상의 데이터를 변경하는 특수한 상황에 이를 사용한다.</li>\n</ul>\n</li>\n<li>\n<p><code class=\"language-text\">hibernate.jdbc.batch_size</code> 속성의 값을 변경시켜 SQL 배치 실행 시 모을 데이터의 수를 지정할 수 있다.</p>\n<ul>\n<li>SQL 배치는 같은 SQL일 때만 유효하다.</li>\n</ul>\n</li>\n</ul>\n<blockquote>\n<p>엔티티를 데이터베이스에 저장해야 식별자를 구할 수 있는 IDENTITY 식별자 생성 전략은 쓰기 지연을 활용한 성능 최적화를 할 수 없다.</p>\n</blockquote>\n<p><strong>📌 트랜잭션을 지원하는 쓰기 지연과 애플리케이션 확장성</strong><br/>\n트랜잭션을 지원하는 쓰기 지연과 변경 감지 기능 덕에 <strong>데이터베이스 테이블 로우에 락이 걸리는 시간을 최소화</strong>할 수 있다.</p>\n<ul>\n<li>트랜잭션을 커밋해서 영속성 컨텍스트를 플러시하기 전까지는 데이터베이스에 데이터를 등록, 수정, 삭제하지 않는다.</li>\n<li>따라서 커밋 직전까지 데이터베이스 로우에 락을 걸지 않는다.</li>\n</ul>\n<p>JPA는 커밋을 해야 플러시를 호출하고 데이터베이스에 수정 쿼리를 보낸다.</p>\n<ul>\n<li>\n<p>쿼리를 보내고 바로 트랜잭션을 커밋하므로 결과적으로 데이터베이스에 락이 걸리는 시간을 최소화한다.</p>\n<ul>\n<li>동시에 더 많은 트랜잭션을 처리할 수 있게 하는 장점이다.</li>\n</ul>\n</li>\n</ul>\n<h2>📕 출처</h2>\n<ul>\n<li><strong>자바 ORM 표준 JPA 프로그래밍</strong> - 김영한</li>\n<li><a href=\"https://leejaedoo.github.io/performance/\">자바 ORM 표준 JPA 프로그래밍</a></li>\n<li><a href=\"https://en.wikipedia.org/wiki/Double_dispatch\">더블 디스패치</a></li>\n<li><a href=\"https://ko.wikipedia.org/wiki/%EB%8D%B0%EC%9D%B4%ED%84%B0%EB%B2%A0%EC%9D%B4%EC%8A%A4_%EC%BB%A4%EC%84%9C\">커서</a></li>\n</ul>","frontmatter":{"title":"📚 15. 고급 주제와 성능 최적화","date":"April 10, 2022","update":"April 10, 2022","tags":["Java","JPA","SpringBoot"],"series":"📚 ORM 표준 JPA"},"fields":{"slug":"/[JPA]15/","readingTime":{"minutes":34.315}}},"seriesList":{"edges":[{"node":{"id":"66d0397b-0a88-53f8-9e40-01878853acdd","fields":{"slug":"/[JPA]1/"},"frontmatter":{"title":"📚 1. JPA 소개"}}},{"node":{"id":"f86fa867-f096-52ce-854a-ef00e49ebcdb","fields":{"slug":"/[JPA]2/"},"frontmatter":{"title":"📚 2. JPA 시작"}}},{"node":{"id":"ffb8392d-d300-51c1-8e71-a8943ef4b58d","fields":{"slug":"/[JPA]3/"},"frontmatter":{"title":"📚 3. 영속성 관리"}}},{"node":{"id":"f45d0c27-c0da-5191-8c86-2aef34b75f27","fields":{"slug":"/[JPA]4/"},"frontmatter":{"title":"📚 4. 엔티티 매핑"}}},{"node":{"id":"c710307c-927c-5c1b-80fb-c45a4ff20616","fields":{"slug":"/[JPA]5/"},"frontmatter":{"title":"📚 5. 연관관계 매핑 기초"}}},{"node":{"id":"24c890e9-eebe-56bf-9db2-8660dcb3b783","fields":{"slug":"/[JPA]6/"},"frontmatter":{"title":"📚 6. 다양한 연관관계 매핑"}}},{"node":{"id":"26e75089-52ac-5b50-98c9-c2806068b034","fields":{"slug":"/[JPA]7/"},"frontmatter":{"title":"📚 7. 고급 매핑"}}},{"node":{"id":"ac8c493e-a661-53a5-989d-b84fcb728ed1","fields":{"slug":"/[JPA]8/"},"frontmatter":{"title":"📚 8. 프록시와 연관관계 관리"}}},{"node":{"id":"5003d7a8-381f-550d-aecd-28caba14aba9","fields":{"slug":"/[JPA]9/"},"frontmatter":{"title":"📚 9. 값 타입"}}},{"node":{"id":"a41dc548-d976-533a-a680-96e86a627d35","fields":{"slug":"/[JPA]10/"},"frontmatter":{"title":"📚 10. 객체지향 쿼리 언어"}}},{"node":{"id":"4ef1a134-ac1d-5e69-9f85-7c1b5d7a8244","fields":{"slug":"/[JPA]11/"},"frontmatter":{"title":"📚 11. 웹 애플리케이션 제작"}}},{"node":{"id":"1a74ae89-3758-5cb9-938c-b8238d176c8c","fields":{"slug":"/[JPA]12/"},"frontmatter":{"title":"📚 12. 스프링 데이터 JPA"}}},{"node":{"id":"5900f638-1417-5a4a-a147-a228540a920b","fields":{"slug":"/[JPA]13/"},"frontmatter":{"title":"📚 13. 웹 애플리케이션과 영속성 관리"}}},{"node":{"id":"5f07d9ea-eadc-54ea-90b2-efe93297170f","fields":{"slug":"/[JPA]14/"},"frontmatter":{"title":"📚 14. 컬렉션과 부가 기능"}}},{"node":{"id":"838bd515-9bd3-5d4b-8f49-723d3f55688c","fields":{"slug":"/[JPA]15/"},"frontmatter":{"title":"📚 15. 고급 주제와 성능 최적화"}}},{"node":{"id":"1f449b33-36ba-58f9-915f-be058ee6ba3e","fields":{"slug":"/[JPA]16/"},"frontmatter":{"title":"📚 16. 트랜잭션과 락, 2차 캐시"}}}]},"previous":{"fields":{"slug":"/[JPA]14/"},"frontmatter":{"title":"📚 14. 컬렉션과 부가 기능"}},"next":{"fields":{"slug":"/[Programmers]43165/"},"frontmatter":{"title":"👩‍💻 43165. 타겟 넘버"}}},"pageContext":{"id":"838bd515-9bd3-5d4b-8f49-723d3f55688c","series":"📚 ORM 표준 JPA","previousPostId":"5f07d9ea-eadc-54ea-90b2-efe93297170f","nextPostId":"6f6804dc-22a3-5271-be8a-786a5934477b"}},"staticQueryHashes":[]}